
In questo articolo tecnico vorrei discutere di come (e probabilmente come non farlo) sviluppare una correzione delle distorsioni ottiche. problema ottico comune, e uno che in realtà può essere compensato utilizzando un algoritmo perché, anche se l'immagine è distorta, può comunque essere priva di aberrazioni frontali. Credo che il titolo dica già in volgarità che si tratterà di un seguito della mia storia d'amore con la decomposizione del valore singolare.
Questo problema è interessante non solo perché è comune, ma anche perché dimostra chiaramente cosa sia la SVD e i suoi punti di forza intrinseci. Prima di entrare nel merito con alcuni numeri, diamo un contesto generale.
Assunti sul problema da risolvere
Per un sistema ben allineato e con una distorsione progettata in modo ottimale, abbiamo la simmetria rotazionale e il polinomio radiale sarà il modo migliore per affrontare questo effetto. Tuttavia, questo non è il problema che mi interessa. Il problema che vorrei affrontare è quello in cui la distorsione è piccola e quando la misuriamo non possiamo ignorare il rumore di misura. Tuttavia, anche se questa distorsione è piccola, non è abbastanza piccola da essere ignorata. Dove potremmo trovare un’applicazione simile? Penso che la litografia possa essere un esempio in cui potremmo puntare a correggerla fino a un livello inferiore al 1/100. A questo livello di precisione, non possiamo assumere nulla sulla natura della distorsione. L’ottica è di ottima qualità e c’è ancora una distorsione che possiamo misurare.
Il problema della correzione del problema della distorsione si inserisce bene nel quadro teorico della SVD perché possiamo raccogliere i dati per adattarli al formalismo della matrice. Pertanto, supporò che raccoglieremo le informazioni sulla distorsione su una griglia che copra uniformemente un'immagine rettangolare.
Perciò iniziamo subito, con entrambi i piedi. Vediamo cosa possiamo aspettarci da questo approccio. Per generare alcuni dati di distorsione che possiamo sperimentare, ho scritto uno script in Matlab/Octave. I lettori che vogliono sperimentare questo possono scaricarlo. qui. (Siete invitati a inviare una e-mail a Contatto per ottenere l'accesso se non lo avete già)
N = 6;
[x,y] = meshgrid(-10:10, -13:13);
x = x/max(x(:));
y = y/max(y(:));
%a = randn(1,(N+1)*(N+2)/2).*(1:((N+1)*(N+2)/2))/N^2;
fx = a(1)*x + a(2)*y + ...
      a(3)*x.^2 + a(4)*x.*y + a(5)*y.^2 + ...
      a(6)*x.^3 +  a(7)*x.^2.*y + a(8)*x.*y.^2 + a(9)*y.^3 + ...
      a(10)*x.^4 + a(11)*x.^3.*y + a(12)*x.^2.*y.^2 + a(13)*x.*y.^3 + a(14)*y.^4 + ...
      a(15)*x.^5 + a(16)*x.^4.*y + a(17)*x.^3.*y.^2  + a(18)*x.^2.*y.^3 + a(19)*x.*y.^4 + a(20)*y.^5 ;
%     a(20)*x.^6 + a(21)*x.^5.*y + a(22)*x.^4.*y.^2 + a(23)*x.^3.*y.^3 + a(24)*x.^2.*y.^4 + a(25)*x.*y.^5 + a(26)*y.^6;

%b = randn(1,(N+1)*(N+2)/2).*(1:((N+1)*(N+2)/2))/N^2;
fy = b(1)*x + b(2)*y + ...
     b(3)*x.^2 + b(4)*x.*y + b(5)*y.^2 + ...
     b(6)*x.^3 + b(7)*x.^2.*y + b(8)*x.*y.^2 + b(9)*y.^3 + ...
     b(10)*x.^4 + b(11)*x.^3.*y + b(12)*x.^2.*y.^2 + b(13)*x.*y.^3 + b(14)*y.^4 + ...
     b(15)*x.^5 + b(16)*x.^4.*y + b(17)*x.^3.*y.^2 + b(18)*x.^2.*y.^3 + b(19)*x.*y.^4 + b(20)*y.^5;
%     b(21)*x.^6 + b(22)*x.^5.*y + b(23)*x.^4.*y.^2 + b(24)*x.^3.*y.^3 + b(25)*x.^2.*y.^4 + b(26)*x.*y.^5 + a(27)*y.^6;

fx = fx + 1 *randn(size(fx))/400;
fy = fy + 1*randn(size(fy))/400;
[ux,sx,vx] = svd(fx);
[uy,sy,vy] = svd(fy);
SVD e separazione delle variabili – un’analogia
Il codice sopra è solo un'espansione di MacLaurin di ordine 5 con coefficienti casuali. L'espansione definisce i spostamenti lungo l'asse delle coordinate su un griglia che analizziamo utilizzando la decomposizione dei valori singolari. Il risultato di un'analisi dei valori singolari è una decomposizione della matrice in tre termini,
La matrice “S” è diagonale e (convenzionalmente) ordinata in ordine decrescente. Le colonne della U e V Le matrici sono ortogonali e (di solito) normalizzate,
Prima di approfondire i dettagli dell’analisi della distorsione del nostro modello, vorrei collegare la SVD a qualcosa che la maggior parte dei lettori potrebbe già conoscere: il metodo della separazione delle variabili. Quando vogliamo risolvere analiticamente una equazione differenziale parziale, assumiamo che la soluzione possa essere scritta come:,
Questo ci porta alla soluzione che scriviamo come:,
Questo è esattamente lo scopo della decomposizione del valore singolare: offre un modo per scrivere la nostra matrice. M come prodotto di funzioni che spaziano indipendentemente nello spazio riga e colonna della matrice. Quando abbiamo preparato i nostri input, abbiamo fatto qualcosa di simile, dove le nostre “funzioni di base” erano tutte combinazioni di potenze di x e poteri y multiplicata per un coefficiente (random) specifico. L'analisi SVD ha ridotto il nostro insieme di 20 funzioni input a due set (U e V) di 6 funzioni. Questo si può vedere eseguendo lo script (una versione completa dello script può essere scaricata). qui)
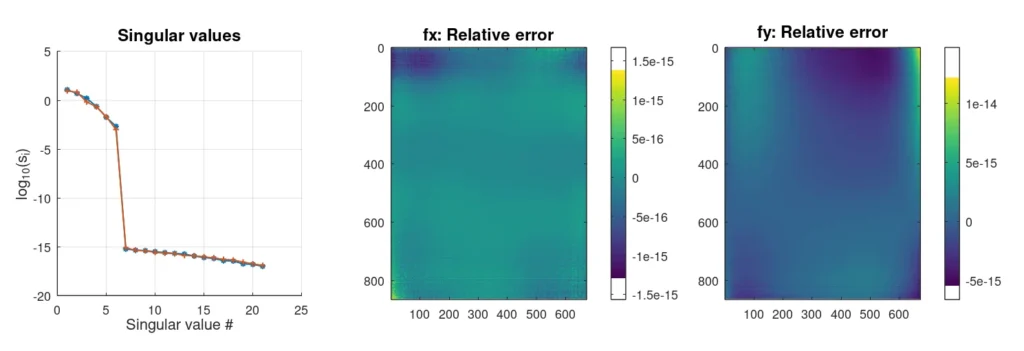
I risultati sopra riportati sono stati ottenuti senza aggiungere rumore, per distinguere chiaramente ciò che è una soluzione e ciò che è (in numeri) uguale a zero.
Analizzando la distorsione con il rumore
Quando ci confrontiamo con dati reali, almeno per le ipotesi che ho esposto sopra, non possiamo presumere di conoscere la dimensione della nostra espansione. Questo è qualcosa che dobbiamo ancora capire. Pertanto, diamo un po’ di rumore e vediamo come si presenta.,
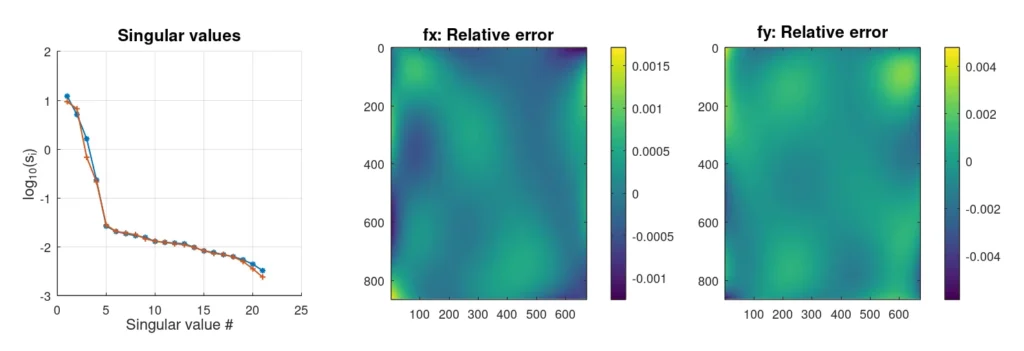
Con l'aggiunta del rumore, la struttura dei valori singolari appare diversa. Mentre nel primo caso i valori singolari diminuiscono di 12 ordini di grandezza dopo i primi 6, ora si ha quello che sembra una sovrapposizione tra due linee rette. In realtà questo è abbastanza comune quando si aggiunge rumore bianco. Per il nostro modello di distorsione, il rumore bianco è probabilmente una buona ipotesi perché le misure dovrebbero essere indipendenti.
Lo script ci mostra ora anche che il nostro recupero della distorsione (upsampling 32×32 volte) non è perfetto. Il rumore non ci permette di recuperare in modo affidabile più di 5 componenti. Potremmo anche sostenere che il rumore della quinta componente sia dato o che sia un dato. Effettuando il script abbastanza volte per raccogliere alcune statistiche, la mia conclusione è stata che l’errore era inferiore se consideriamo che si tratta di dati e li includiamo. Ancora più interessante è il fatto che, includendo quel quinto punto, la mappatura ha eliminato gli outlier che altrimenti apparirebbero 1,5% o 2% volte durante la ripetizione della simulazione.
L’aggiunta del quinto termine ha un valore molto specifico. Facilita di conseguenza che la distribuzione degli errori risulti abbastanza gaussiana. Secondo gli occhi (o il cuore) del nostro ingegnere, dovrebbe essere molto desiderabile. Gli outlier possono rivelarsi molto costosi in ambito ingegneristico, causando ritardi e frustrazione. Per concludere, con l’espressione “outlier” intendo un evento la cui frequenza non è prevista dalla statistica gaussiana, come ad esempio un errore di 6 deviazioni standard che si verifica una volta su mille campioni. Un evento del genere dovrebbe richiedere due miliardi di campioni.
Commenti sullo script
Ci sono alcune cose nel sceneggiatura Questo aspetto potrebbe valere la pena di essere approfondito. Ciò che mi sembra più inquietante è che quando interpoliamo e ridimensioniamo i vettori singolari sinistri e destri (le colonne delle matrici U e V), questi non sono più ortogonali. Ciò significa che non possiamo utilizzare i vettori interpolati per proiettare altre distribuzioni su questo spazio. La mancanza di ortogonalità non sembra tuttavia comportare alcun pregiudizio nella ricostruzione.
Inoltre, le interpolazioni utilizzano il numero dei valori singolari estratti come ordine del polinomio utilizzato per l’interpolazione. È facile sostenere questa scelta per un modello del genere. Tuttavia, questa scelta sarebbe una delle prime che vorrei provare a confermare (o a rifiutare) quando mi trovo di fronte a dati reali.
Se questo vi è sembrato interessante, lasciate un commento. Non mi dispierebbe riscrivere questo programma in linguaggio C open source e includere la pre-interpolazione dei dati di input. Inoltre, ci sono alcune considerazioni numeriche molto interessanti riguardo alla struttura dei dati per rendere possibile l’applicazione di questa teoria, che permette di gestire i tassi di mappatura di gigapixels al secondo, cosa che sembra possibile con CPU generiche.
Grazie per aver letto.