
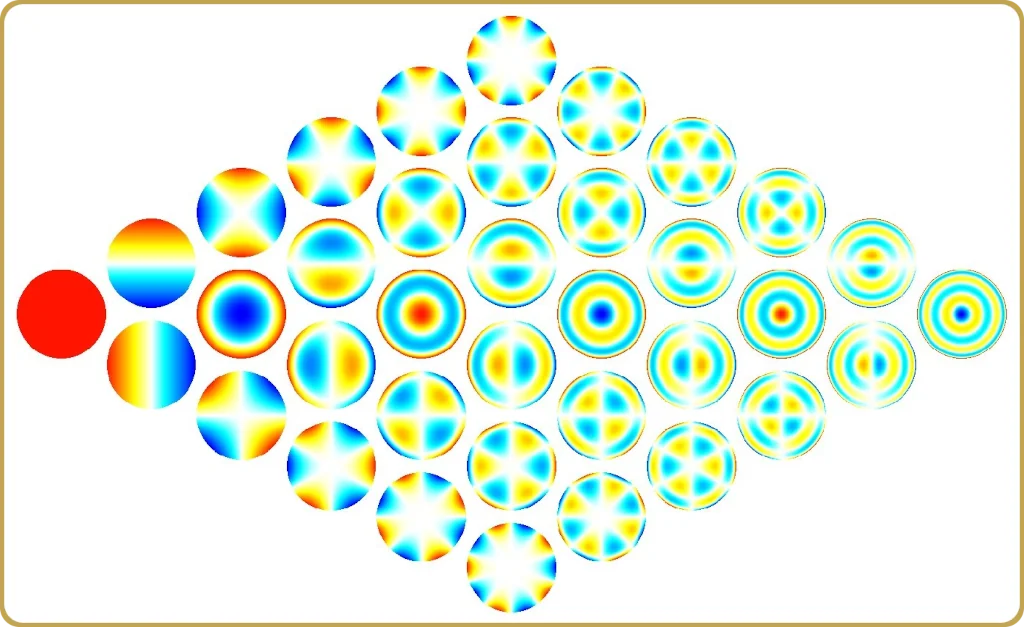
I polinomi di Zernike, li riconosciamo tutti, e sono il linguaggio che spesso usiamo quando descriviamo i sistemi ottici. Ma sono sempre la scelta giusta?
C’è un linguaggio sbagliato? Alla fine, cerchiamo di portare un design al suo minimo, e possiamo pensare che non sia importante. Ma il modo in cui affrontiamo il concetto di zero è importante.
Cosa succede se non possiamo arrivare a zero, o nel tolerancing possiamo scegliere di spingere questo o quello termine, ma non entrambi? Come facciamo a scegliere? Se stiamo costruendo un telescopio, la situazione è chiara. Vogliamo minimizzare la varianza del fronte d’onda e, in questo modo, massimizzare il rapporto Strehl. Questo è calcolato molto chiaramente da Born & Wolf. Questa è la scelta giusta per il linguaggio Zernike.
Ma se la proprietà di cui siamo interessati non deriva dalla varianza? Come facciamo a saperlo?
Un'analisi che può essere utilizzata consiste nel trovare l'espansione MacLaurin della proprietà di interesse di secondo ordine utilizzando il polinomio Zernike come sonde o semplicemente come parametri liberi. Per questo scopo si può utilizzare un approccio Monte Carlo o un approccio Latine Hypercube Sampling, e la scelta migliore è discussa altrove. Tuttavia, una volta fatto ciò, possiamo trovare la dipendenza c (offset), v (lineare) e A (quadrata) che meglio si adatta ai dati, e questa aderenza può essere molto buona.
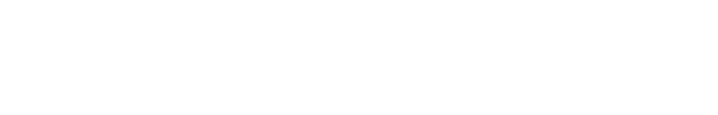
Se A se risulta che non è diagonalità in questa espansione, allora i polinomi di Zernike non sono la giusta lingua perché non si può concludere che minimizzare uno dei coefficienti migliori la nostra proprietà di interesse. In questo caso, diagonalizzare A ci darà una nuova base ortogonale.
Tuttavia, prima di porre la domanda su quale dei termini ridurre, ma nella nuova base, che cosa ne sarà del termine lineare? v. La risposta a questa domanda è: dipende.
Ovviamente c'è la possibilità di guardare alla soluzione f = 0, e se questa soluzione rientra nel range di validità dell'espansione, probabilmente abbiamo trovato una soluzione non triviale in cui le aberrazioni non nulle generano un errore zero. Questo accade (ma è insolito), ma molto spesso si tratta di uno dei due casi: v è essenzialmente zero o la soluzione a f = 0 non rientra nel range di espansione, soprattutto perché v è residuo del processo di adattamento.
Quando il termine lineare v Se il valore è zero, allora si pone la stessa domanda che si era posta inizialmente: dovremmo migliorare questo o quell’elemento nella nuova base? La risposta è che non importa, perché nella nuova base gli elementi sono indipendenti e possiamo scegliere di migliorare quello che offre il maggiore effetto.
È certamente un approccio un po’ esoterico, ma dato che disponiamo dei modelli del nostro sistema ottico e della proprietà di interesse, sondare 15-20 parametri liberi utilizzando poche migliaia di simulazioni può essere completamente fattibile e fornisce informazioni preziose sui fondamentali del sistema ottico. Spesso questo può essere fatto in meno di un giorno se già disponiamo dei modelli. Su GPU, ancora più velocemente.
Ma il punto davvero profondo è che, una volta che vediamo come funzionano le cose, possiamo riutilizzarle nel nostro design di alto livello. Esemplo: Dovremmo sempre evitare le sensibilità lineari. È un segnale che potremmo essere in procinto di fare qualcosa di sbagliato. Capita che questo sia inevitabile. Allora è quello che succede, ma se questo si presenta come una sorpresa, è sicuramente qualcosa che dobbiamo riutilizzare nel nostro sistema di design di alto livello per vedere se non si tratta di qualcosa che può essere eliminato.